 Svenesis.org
21. September 2026 · 🔭 Astronomie 🖥️ Technologie
Wie gut war die Vorhersage? Ich habe mein eigenes Astro-Wetter nachgerechnet
Man baut sich ein Werkzeug, es sagt „Ausgezeichnet, 90 %“, man fährt raus – oder startet das Rig in Texas aus der Ferne. Was man nie tut: nachsehen, ob es recht hatte. Wetterdienste veröffentlichen ihre Trefferquoten. Ein selbstgebautes Tool veröffentlicht gar nichts, es behauptet einfach.
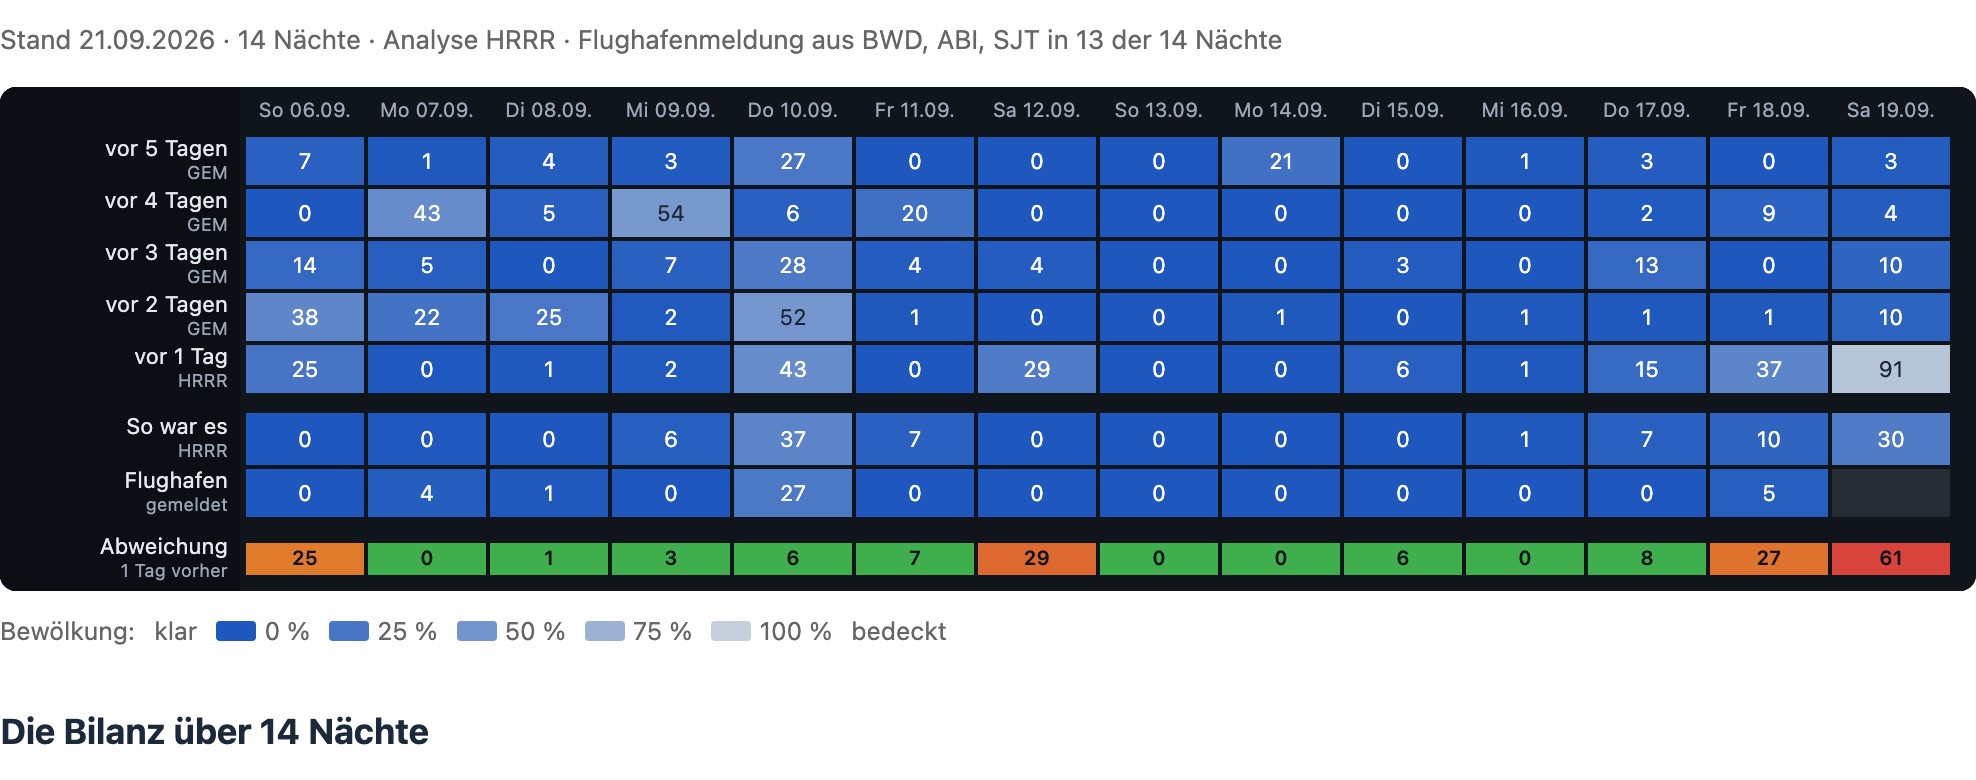
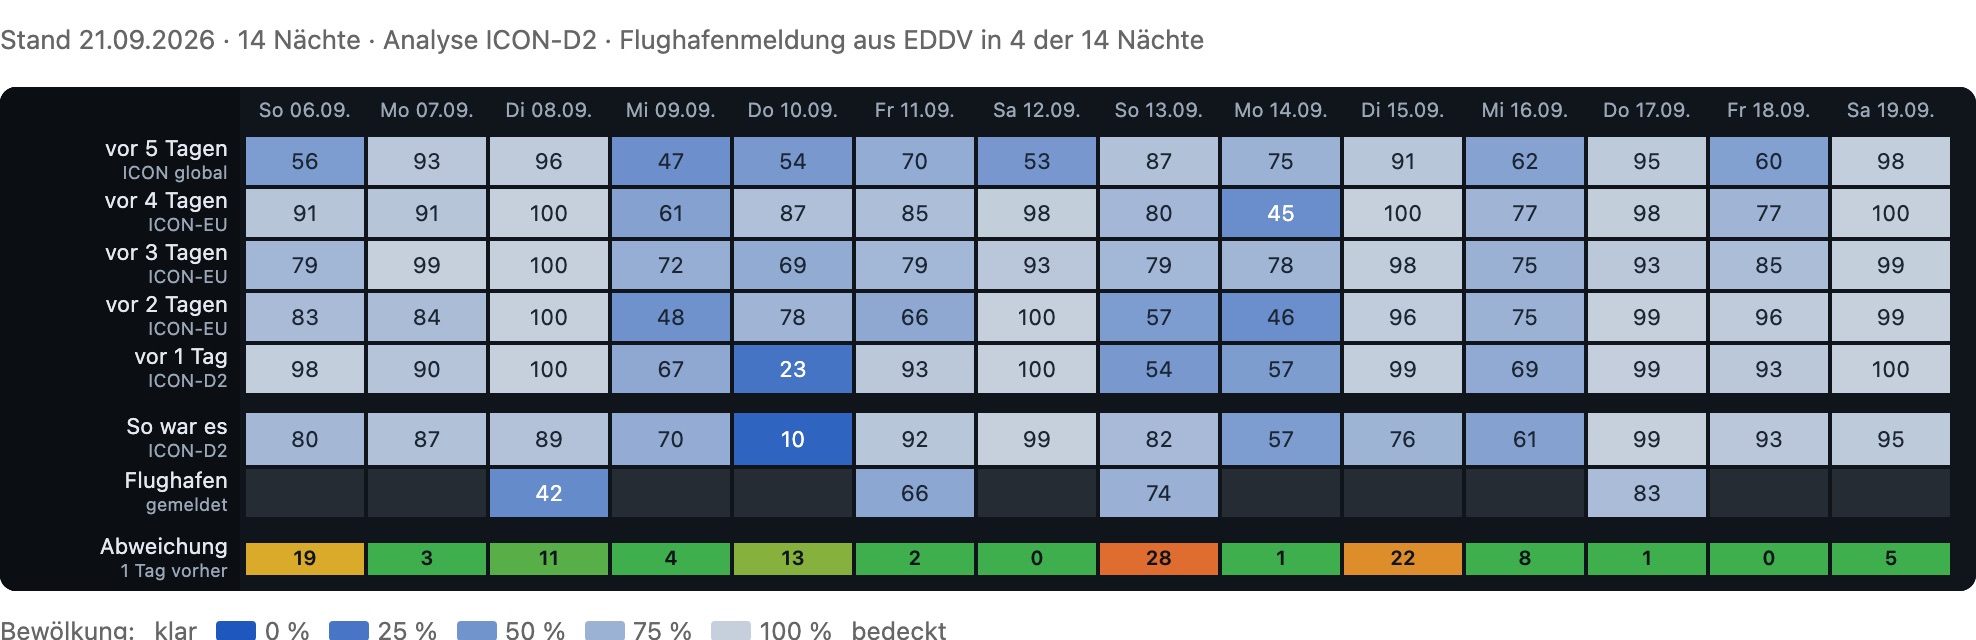
Das hat mich gestört. Also habe ich dem Astro-Wetter eine zweite Seite danebengestellt, die es überprüft: die Astro-Wetter-Historie. Für jede Nacht der letzten Wochen steht dort nebeneinander, was die Vorhersage ein bis fünf Tage vorher sagte, was daraus wurde und was die Flughäfen in der Nähe tatsächlich gemeldet haben.
Dieser Artikel erklärt, woher diese Daten kommen, warum die Frage „was war eigentlich wirklich?“ schwerer zu beantworten ist als erwartet – und was 60 Nächte an vier Standorten über die Verlässlichkeit der Vorhersage sagen. Das Ergebnis hat mich in einem Punkt wirklich überrascht.
Woher man weiß, was vorhergesagt war
Der Knackpunkt ist nicht, herauszufinden, wie das Wetter war. Der Knackpunkt ist, an die alte Vorhersage zu kommen – also an das, was am Dienstag für den Freitag stand, nachdem der Freitag längst vorbei ist. Wer nichts mitschreibt, hat sie verloren.
Open-Meteo schreibt mit. Die API hat dafür einen eigenen Endpunkt, previous-runs, und der war die Entdeckung, ohne die diese Seite nicht existieren würde:
| Archiv | Was drinsteht | Reicht zurück |
|---|---|---|
| previous-runs | Was vorhergesagt war, aufgeschlüsselt nach Vorlaufzeit: cloud_cover_previous_day1 bis day8 | 92 Tage |
| Vergangenheit der normalen API | Was war – in Texas identisch mit der HRRR-Analyse, auf die Stunde genau nachgeprüft | rund 70 Tage |
| Reanalyse-Archiv | ERA5 mit 25 km, ECMWF IFS mit 9 km, CERRA mit 5 km für Europa | ERA5 bis 1940 |
| Flughafenmeldungen | Die stündlichen METAR-Wolkenangaben, im Archiv der Iowa State University | Jahrzehnte |
Die ersten drei kosten nichts und verlangen keinen Schlüssel; das vierte ist ein öffentliches Universitätsarchiv. Zusammen ergeben sie genau das, was man für eine ehrliche Nachrechnung braucht: die damalige Vorhersage, mehrere unabhängige Schätzungen des Ausgangs – und eine echte Messung.
Was sich nicht nachspielen lässt
Hier musste ich den Anspruch zurücknehmen. Das Vorhersagearchiv führt je Vorlaufzeit die Gesamtbewölkung, Feuchte, Temperatur, Taupunkt, Bodenwind und den Wettercode. Es führt nicht: die Wolken nach Höhe, die Sichtweite, die Winde in 250 und 850 hPa und die Aerosol-Dichte.
Damit lassen sich zwei der drei geschätzten Zeilen des Astro-Wetters nicht rekonstruieren. Seeing rechnet sich aus dem Windprofil in der Höhe – die Daten gibt es rückwirkend nach Vorlaufzeit nicht. Transparenz kommt aus der CAMS-Aerosolvorhersage – dasselbe. Und ohne beide auch die Gesamtnote nicht.
Das klingt schlimmer, als es ist. In der Gesamtnote bestimmen die Wolken ohnehin fast alles: Sie gehen quadriert ein, Seeing und Transparenz schattieren eine ohnehin klare Stunde nur noch. Halb bedeckt heißt höchstens 25 %, egal wie ruhig die Luft steht. Die Historie vergleicht deshalb nur die Bewölkung – und schreibt das auf der Seite auch hin, statt eine Vollständigkeit vorzutäuschen, die sie nicht hat.
Das eigentliche Problem: Es gibt keine eine Wirklichkeit
Ich war davon ausgegangen, dass der schwierige Teil die Vorhersage ist und „was tatsächlich war“ einfach feststeht. Das stimmt nicht. Bewölkung wird flächendeckend nicht gemessen, sondern gerechnet – auch rückwirkend. Und die Rückrechnungen sind sich uneinig:
| Zwei Rückblicke auf denselben Zeitraum | Unterschied |
|---|---|
| IFS-Analyse (9 km) gegen HRRR-Analyse (3 km) | 12,5 Prozentpunkte |
| IFS-Analyse gegen ERA5 (25 km) | 14,2 Prozentpunkte |
| ERA5 gegen HRRR-Analyse | 16,5 Prozentpunkte |
Zum Vergleich: Der Fehler der Ein-Tages-Vorhersage liegt an Starfront bei 13 Prozentpunkten. Zwei dieser drei Wahrheiten liegen weiter auseinander, als die Vorhersage von derjenigen entfernt ist, an der ich sie messe. Wer eine davon als „so war es“ hinstellt und alles daran misst, misst zu einem guten Teil sich selbst.
Deshalb zeigt die Seite zwei Bezugsgrößen statt einer: die Analyse des feinsten Modells der Kette – und darunter, wo es sie gibt, die Flughafenmeldung. Die ist die einzige echte Messung im ganzen Aufbau: ein Ceilometer schießt einen Laserpuls nach oben und misst, in welcher Höhe er zurückgestreut wird. Kein Modell, kein Gitter, keine Interpolation.
Sie hat dafür zwei harte Grenzen. Erstens sieht sie nur bis rund 3,7 km hinauf – Cirrus darüber, für die Astrofotografie oft genau das Entscheidende, taucht in ihr nicht auf. Zweitens steht sie am Flughafen und nicht an der Sternwarte – an der Finca in Andalusien ist der nächste meldende Flughafen Gibraltar, 40 km entfernt und auf Meereshöhe, während die Finca in den Bergen liegt.
Wie viel das ausmacht, lässt sich messen – und es war die größte Überraschung dieser ganzen Übung. Ich vergleiche dazu die Flughafenmeldung mit der Gesamtbewölkung der Analyse – über dieselben 60 Nächte vom 23. Juli bis zum 20. September – und schaue nicht auf den Betrag, sondern auf die Richtung:
| Standort | Flughafen liest klarer als das Modell |
|---|---|
| Starfront (Texas) | 0,4 Prozentpunkte |
| Finca Olivar, Gaucín | 10,0 |
| Volkssternwarte Hannover | 46,4 |
| Sankt Andreasberg | 48,9 |
Über dem trockenen Texas sind sich Laser und Modell praktisch einig – 0,4 Prozentpunkte über 59 Nächte. Das macht die Analyse dort zu einer belastbaren Bezugsgröße. In Norddeutschland klaffen sie um fast fünfzig Punkte auseinander, und das ist kein Messfehler: Es ist die mittelhohe und hohe Bewölkung, die das Ceilometer schlicht nicht sieht. In den Stunden, in denen die Station „unten nichts“ meldet, sagt das Modell im Schnitt 16 % tiefe, aber 44 % mittelhohe und 36 % hohe Bewölkung. Die Station hat recht – sie beantwortet nur eine andere Frage als die, die ein Astrofotograf stellt.
Welches Modell eigentlich welche Vorhersage gemacht hat
Ein Punkt, den ich beim Bauen unterschätzt hatte: Die Vorhersage für „in drei Tagen“ kommt gar nicht aus demselben Modell wie die für morgen. Das Astro-Wetter nimmt immer das feinste Modell, das noch so weit reicht – und die feinen reichen nicht weit. HRRR mit 3 km reicht etwa 48 Stunden, ICON-D2 mit 2,2 km ähnlich – genug für die kommende Nacht, nicht mehr für die übernächste. Danach übernimmt das nächstgröbere.
Die Historie bildet genau diese Regel nach, rückwirkend: Für jede Vorlaufzeit nimmt sie das erste Modell der Kette, das überhaupt einen Lauf hat. (Genau an dieser Stelle hat die Nachrechnung später etwas verändert – dazu weiter unten.) Die Kurzfristmodelle fallen dann von selbst heraus. Herausgekommen ist diese Aufteilung – sie steht auf der Seite links neben jeder Zeile:
| Standort | 1 Tag | 2 Tage | 3–4 Tage | 5 Tage |
|---|---|---|---|---|
| Starfront (Texas) | HRRR | GEM | GEM | GEM |
| Hannover, Sankt Andreasberg | ICON-D2 | ICON-EU | ICON-EU | ICON global |
| Gaucín (Andalusien) | ICON-EU | ICON-EU | ICON-EU | ICON global |
Gaucín hat keine feine Stufe: Die Finca liegt südlich des ICON-D2-Gebiets und südlich des HARMONIE-Gebiets des dänischen Wetterdienstes. Die API liefert für diese Modelle dort nicht etwa Nullen, sondern gar keinen Schlüssel – was die Kettenregel richtig behandelt, ohne dass man es ihr sagen muss.
Und jetzt die Zahlen
60 Nächte, 23. Juli bis 20. September 2026. Gemessen wird das Mittel über die astronomische Dunkelheit, jede Stunde gewichtet mit ihrem dunklen Anteil – dieselbe Rechnung, mit der das Astro-Wetter seinen Nachtschnitt bildet. Eine Nacht zählt nur, wenn mindestens 80 % ihrer Dunkelheit Daten haben – diese Regel kostet an manchen Standorten ein paar Nächte, deshalb steht in der Tabelle unten nicht überall 60.
| Standort | 1 Tag vorher | 3 Tage vorher | 5 Tage vorher | brauchbare Nächte |
|---|---|---|---|---|
| Starfront (Texas) | 13,0 | 6,2 | 5,9 | 59 von 60 |
| Volkssternwarte Hannover | 13,0 | 20,7 | 24,9 | 14 von 57 |
| Sankt Andreasberg | 11,6 | 13,8 | 25,9 | 14 von 59 |
| Finca Olivar, Gaucín | 11,2 | 14,4 | 18,9 | 39 von 59 |
Mittlerer absoluter Fehler in Prozentpunkten Bewölkung, kleiner ist besser. „Brauchbar“ heißt hier: im Mittel unter 30 % bedeckt.
In Europa verhält es sich, wie man es erwartet: Je weiter voraus, desto schlechter – in Hannover fast eine Verdopplung des Fehlers zwischen einem und fünf Tagen. In Texas passiert das nicht. Dort wird die Vorhersage mit größerem Vorlauf sogar besser. Der Grund steht in der letzten Spalte: 59 von 60 Nächten waren brauchbar. Im texanischen Spätsommer ist „klar“ die richtige Antwort, und die trifft man auch fünf Tage vorher.
Der eine Befund, der mich überrascht hat
Genau dieselbe Spalte macht aber auch etwas anderes sichtbar, und das ist der interessanteste Teil der ganzen Übung. Die Trefferquote allein sähe in Texas fantastisch aus – je nach Vorlaufzeit 82 bis 93 % richtige Aussagen. Nur: Wer jede Nacht stur „wird klar“ sagt, käme dort auf 98 %. Eine Quote ist ohne ihre Grundrate wertlos.
Also habe ich die Aussagen getrennt ausgewertet – Versprechen und Warnungen einzeln:
| Drei Tage vorher gesagt … | Starfront (Texas) | Hannover |
|---|---|---|
| „Wird brauchbar“ – und wurde es auch | 56 von 57 (98 %) | 6 von 12 (50 %) |
| „Wird nichts“ – und wurde auch nichts | 0 von 3 (0 %) | 37 von 45 (82 %) |
Das ist ein sauberes Spiegelbild. In Texas tragen die Versprechen – und die drei Warnungen, die es gab, waren alle drei falsch: Jede dieser Nächte wurde doch brauchbar. Drei Nächte sind eine Anekdote und keine Quote, aber sie zeigen in dieselbe Richtung wie die HRRR-Zahlen weiter unten. In Hannover ist es genau umgekehrt: Wenn dort „wird nichts“ steht, stimmt das in vier von fünf Fällen. Wenn „wird gut“ steht, ist es ein Münzwurf.
Dahinter steckt keine Modellschwäche, sondern Statistik: Eine Vorhersage trifft immer das gut, was ohnehin häufig ist. Seltene Ereignisse vorherzusagen ist schwer, und die seltene Ansage ist die unzuverlässige – in Texas die schlechte Nacht, in Norddeutschland die gute. Wer das weiß, liest dieselbe Anzeige an zwei Orten richtigerweise verschieden.
Und dann war da noch HRRR
Ein Detail in der Tabelle oben habe ich zunächst für einen Rechenfehler gehalten: An Starfront ist die Ein-Tages-Vorhersage schlechter als die Drei-Tages-Vorhersage. 13,0 gegen 6,2 Prozentpunkte – das ist keine Kleinigkeit, das ist Faktor zwei in der falschen Richtung.
Der Unterschied zwischen den beiden Zeilen ist das Modell. Bei einem Tag rechnet HRRR, ab zwei Tagen das kanadische GEM. Und HRRR bricht am Ende seiner Reichweite in einzelnen Nächten regelrecht ein. Die vier schlimmsten Fälle der 60 Nächte:
| Nacht | 1 Tag vorher (HRRR) | 3 Tage vorher (GEM) | Tatsächlich |
|---|---|---|---|
| 20. August | 86 % | 8 % | 0 % |
| 28. August | 77 % | 0 % | 24 % |
| 4. September | 73 % | 36 % | 0 % |
| 20. September | 91 % | 10 % | 30 % |
Viermal eine dicht bewölkte Nacht vorhergesagt – und dreimal wurde sie klar, einmal (20. September) landete sie mit genau 30 % auf der Schwelle. Hätte ich mich am Vorabend darauf verlassen, hätte ich drei gute Nächte verschenkt und eine brauchbare dazu.
Bevor ich das glaube, habe ich es mit einem zweiten, unabhängig geschriebenen Werkzeug nachgemessen – anderes Nachtfenster, andere Bezugsgröße, nämlich direkt die Flughafenmeldungen statt der Analyse. Es bestätigt den Befund: HRRR bei einem Tag Vorlauf 14,2 Punkte, GEM bei drei Tagen 7,3. Zwei Wege, dieselbe Antwort. Es ist jedenfalls kein Artefakt meiner eigenen Rechnung.
Also habe ich die Seite umgebaut
Damit war die Frage nicht mehr, ob etwas zu tun ist, sondern was genau. Dazu musste ich noch eine Messung nachholen, die ich vorher gar nicht gemacht hatte: HRRR gegen GEM bei derselben Vorlaufzeit. Vorher hatte ich nur HRRR bei einem Tag mit GEM bei drei Tagen verglichen – das ist kein fairer Vergleich, sondern zwei verschiedene Fragen.
| Modell | 0 bis 24 Stunden | 24 bis 48 Stunden |
|---|---|---|
| HRRR | 4,6 | 14,2 |
| GEM | 7,7 | 7,9 |
| NAM | 6,2 | 9,7 |
| NBM | 11,5 | 13,3 |
Mittlerer Fehler gegen die Flughafenmeldungen, 59 Nächte, nur dunkle Stunden. Gegen die Modellanalyse statt gegen die Flughäfen kommt dieselbe Reihenfolge heraus.
Damit ist es eindeutig: HRRR ist im ersten Tag das beste Modell, das es hier gibt – und im zweiten das schlechteste der feinen. GEM ist dort fast doppelt so gut. Es geht also nicht darum, HRRR loszuwerden, sondern darum, es rechtzeitig loszulassen.
Seit dem 21. September bekommt HRRR deshalb nur noch 30 Vorhersagestunden statt knapp zwei Tage; danach übernimmt GEM. Warum 30 und nicht 24: Meine Messung löst nur tageweise auf, mehr geben die Daten nicht her – und 30 Stunden verhindern, dass der Schnitt mitten durch die dunkelste Zeit einer Nacht läuft. Er fällt so in den Tag danach, wo ohnehin nichts bewertet wird.
Und weil ich nicht aus einem Standort auf alle schließen wollte, habe ich dieselbe Messung für Europa gemacht. Dort gibt es das Problem nicht: ICON-D2 liegt bei 24 bis 48 Stunden in Hannover bei 13,0 gegen 14,3 von ICON-EU, in Sankt Andreasberg bei 11,5 gegen 11,2. Unentschieden. ICON-D2 bricht am Ende seiner Reichweite nicht ein, und deshalb bleibt es in Europa, wie es war.
60 Nächte sind ein Spätsommer und keine Klimatologie – das gilt auch für diese Entscheidung. Aber sie ist jetzt wenigstens aus Zahlen getroffen statt aus Bauchgefühl, und das Schöne ist: Die Historie misst ab sofort mit, ob sie etwas gebracht hat. In vier Wochen weiß ich es. Genau dafür habe ich die Seite gebaut.
Wo diese Zahlen aufhören
- 60 Nächte sind wenig. Ein Spätsommer, eine Wetterlage. Im texanischen Winter oder im europäischen Hochdruck sieht dieselbe Rechnung anders aus.
- Nur Bewölkung, und davon nur die Gesamtmenge. Über Seeing und Transparenz sagt die Historie nichts – die Daten gibt es rückwirkend nicht.
- Die Bezugsgröße ist meistens selbst ein Modell. Nur an Starfront ist sie durch echte Messung gestützt. In Hannover und Sankt Andreasberg sind die Flughafenzeilen fast leer.
- Cirrus fehlt in den Messungen. Das Ceilometer sieht bis 3,7 km. Die dünne hohe Schicht, die ein Bild ruiniert, ohne dass man sie am Himmel bemerkt, steht in keiner dieser Zahlen.
Wie die Seite gebaut ist
Ein Wort zur Technik. Die erste Fassung hat die Archive auf meinem Rechner abgefragt und das Ergebnis als fertige Datei auf den Server gelegt – sauber, aber mit dem Haken, dass ich dafür regelmäßig ein Skript hätte starten müssen. Eine Seite, die nur dann aktuell ist, wenn ihr Betreiber daran denkt, ist keine gute Seite. Also rechnet sie jetzt live in deinem Browser: Beim Aufruf holt sie die archivierten Vorhersagen direkt von Open-Meteo – eine Anfrage, rund 90 Kilobyte, eine halbe Sekunde – und rechnet Nächte, Dämmerung und Mittelwerte vor Ort aus. Damit ist sie immer auf dem Stand von heute Morgen, ohne dass jemand etwas tun muss.
Die Flughafenmeldungen sind der Sonderfall. Das Archiv der Iowa State University gibt eine Station nach der anderen heraus – fragt man drei gleichzeitig, antwortet es mit „zu viele Anfragen“. Nacheinander mit Pause dauert es sechs bis acht Sekunden. Das will man niemandem beim bloßen Öffnen der Seite zumuten und einem kostenlosen Uni-Archiv auch nicht bei jedem Besuch. Deshalb kommt diese Zeile erst auf Knopfdruck.
Ehrlich dazugesagt: Damit erfährt Open-Meteo beim Aufruf der Seite deine IP-Adresse, und beim Klick auf den Knopf zusätzlich die Iowa State University. Beide stehen mit Zweck und Rechtsgrundlage in der Datenschutzerklärung. Der Beobachtungsplaner macht es bei seinen Bahndaten weiterhin andersherum – dort ändern sich die Daten nur alle paar Wochen, da lohnt sich die fertige Datei.
Sonne, Mond und die exakten Dämmerungsübergänge kommen dabei aus demselben Rechenkern, den die beiden anderen Astro-Seiten benutzen – nicht aus einer zweiten, leicht abweichenden Kopie. Das klingt nach Kleinkram, ist aber der Unterschied zwischen „dieselbe Nacht“ und „ungefähr dieselbe Nacht“.
Was ich mitnehme
Drei Dinge. Erstens: Eine Vorhersage ohne Trefferbilanz ist eine Behauptung. Es hat einen Nachmittag gekostet, das nachzurechnen, und ich habe seitdem ein deutlich anderes Verhältnis zu meiner eigenen Anzeige.
Zweitens: Man muss wissen, was am eigenen Standort selten ist. Dieselbe Zahl bedeutet an der Volkssternwarte etwas anderes als in Texas – und zwar systematisch, nicht zufällig.
Drittens, und das am ehesten übertragbar: Die Frage „woran messe ich das eigentlich?“ war schwieriger als die Messung selbst. Ich hatte erwartet, gegen die Wirklichkeit zu prüfen, und habe stattdessen gelernt, dass es drei davon gibt, die 12,5 bis 16,5 Punkte auseinanderliegen. Das ist keine Ausrede dafür, nicht nachzumessen. Es ist nur der Grund, warum auf der Seite zwei Bezugszeilen stehen statt einer – und warum darunter ein Kasten steht, der sagt, was die Zahlen nicht bedeuten.
Zur Astro-Wetter-Historie →
Vier Standorte, 14 bis 60 Nächte, kostenlos und ohne Konto – wie alles hier.